細胞里的蛋白質,也會像水中的油滴一樣聚在一起、與周圍環境「分開」。這種被稱為「相分離」的過程,既幫助細胞快速應對變化,也可能在失控後形成異常聚集,與阿爾茨海默病等疾病相關。
如今,南洋理工大學(NTU Singapore)研究團隊藉助人工智慧,為科研人員提供了一套更系統的「蛋白質相分離地圖」。
團隊開發了AI驅動的基準資料庫PLATO和分析平台PhaseHub,幫助研究人員更準確地預測哪些蛋白質會發生相分離、它們可能與哪些分子互動,以及這種行為在不同物種中如何變化。
跨物種分析規模
1,106個物種
涵蓋動物、植物、真菌和細菌等生命形式
蛋白質為什麼會「抱團」?
相分離蛋白質會從周圍環境中分離出來,集中形成類似液滴的結構。細胞可以藉此把特定分子聚到一起,加速或抑制某些反應,從而更快地應對壓力。
但如果這一過程發生異常,蛋白質便可能形成有害的凝聚體或聚集物。此類變化與癌症、阿爾茨海默病等神經退行性疾病有關;在植物中,相分離異常也可能削弱壓力響應和抵禦微生物病原體的能力。
因此,找出哪些蛋白質會發生相分離,以及這種行為受什麼因素調控,是疾病、衰老和作物研究中的重要問題。

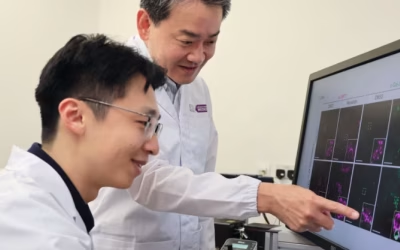
左起:NTU數字分子分析與科學研究所研究員Dr Liang Qiyu與Prof Miao Yansong。 圖源:NTU Singapore
PLATO:給AI一套更可靠的「標準答案」
過去的蛋白質相分離數據集往往偏重完整蛋白質,較少收錄實驗中確認「不發生相分離」的結果,也缺乏截短蛋白質、突變體和工程化變體。這種數據失衡,容易令預測模型高估蛋白質發生凝聚的傾向。
為補上缺口,NTU團隊利用大語言AI模型系統檢索PubMed收錄的科學論文,提取經過實驗測試的蛋白質及其相行為信息,並由研究人員進行人工覆核,以確保科學準確性。
PLATO資料庫收錄:
• 5,118條獨特蛋白質序列
• 超過3,600種會發生相分離的蛋白質
• 約1,300種不會發生相分離的蛋白質
• 同時涵蓋截短蛋白質、突變體及工程化變體
這些更均衡、更多樣的數據,可以為訓練和評估新一代預測工具提供基準。
PhaseHub:不只預測,還能探索「誰和誰互動」
研究團隊還建立了PhaseHub平台。他們先利用此前開發的機器學習算法MolPhase,預測1,106個物種中可能發生相分離的蛋白質,再結合蛋白質丰度和相互作用的實驗數據,分析多組分蛋白質凝聚體。
研究人員可以在PhaseHub中搜索蛋白質或提交序列,查看其相分離預測結果、可視化潛在相互作用,並探索影響分子互動的特徵,例如連續重複的胺基酸片段。

跨越生命物種,團隊發現了什麼?
分析顯示,細胞內含有細胞核的真核生物,通常擁有更高比例的潛在相分離蛋白質。對於基因組較小的生物,潛在相分離蛋白質的比例會隨基因組擴大而增加,之後逐漸趨於平台。
這提示基因組DNA含量與相分離能力之間可能存在一種平衡:更大的基因組可以編碼更多相分離蛋白質,支持更複雜的細胞活動;但過強的凝聚傾向,也可能提高形成有害聚集物的風險。
誰完成了這項研究?
研究由NTU生命科學學院及數字分子分析與科學研究所(IDMxS)的苗延松教授(Prof Miao Yansong)領導,並與NTU電氣與電子工程學院高偉博教授(Prof Gao Weibo)合作完成。
IDMxS研究員梁啟宇博士(Dr Liang Qiyu)是兩篇研究論文的第一作者。相關AI工具與研究成果已發表於同行評審期刊《Molecular Plant》。
這項研究意味著什麼?
它並不是一項已經進入臨床的治療技術,而是一套更準確、更友好的基礎研究工具。未來,它可能幫助科研人員更快篩選候選蛋白質,理解疾病和衰老機制,並研究如何增強植物的抗逆性與免疫力。
從單個蛋白質序列,到覆蓋千餘物種的生命圖譜,AI正在幫助科學家把分散在論文和實驗中的證據連接起來。真正值得期待的,不只是「預測得更快」,更是讓疾病研究和可持續農業獲得一套能夠不斷積累、比較與驗證的共同基礎。